跳到主要内容

Backend Developer Roadmap 2

· 阅读需 25 分钟

Roadmap: https://roadmap.sh/backend

本文隶属于 Roadmap 中的 Internet --> What is HTTP?。

原文:https://cs.fyi/guide/http-in-depth

什么是 HTTP?​

HTTP 是一个基于 TCP/IP 的应用层通信协议,标准化客户端和服务器之间的通信方式。它定义了互联网上请求和传输内容的方式。所谓应用层协议,是指它简单地抽象出了主机(客户端和服务器)之间的通信标准。HTTP 本身依赖于 TCP/IP,在客户端和服务器之间进行请求和响应。默认情况下,使用 TCP 端口 80,但也可以使用其他端口。HTTPS 使用端口 443。

HTTP/0.9 - 1991​

HTTP/0.9 是 HTTP 的第一个版本,于 1991 年提出。它是迄今为止最简单的协议,只有一个叫做 GET 的方法。如果客户端需要访问服务器上的某个网页,它会发送以下简单请求:

GET /index.html

然后服务器的响应会如下所示:

(response body)
(connection closed)

也就是说,服务器会接收请求,响应 HTML 并在内容传输完成后立即关闭连接。HTTP/0.9 没有头部,只允许 GET 方法,响应的内容必须是 HTML。可以看出,该协议实际上只是后来版本的垫脚石。

HTTP/1.0 - 1996​

HTTP/1.0 是 HTTP 的第一个版本,于 1996 年提出。与只能处理 HTML 响应的 HTTP/0.9 不同,HTTP/1.0 现在可以处理其他响应格式,例如图像、视频文件、纯文本或任何其他内容类型。它添加了更多的方法(例如 POST 和 HEAD),请求/响应格式发生了变化,HTTP 头被添加到请求和响应中,状态码被添加以标识响应,引入了字符集支持,多部分类型,授权,缓存,内容编码等。

以下是 HTTP/1.0 请求和响应的示例:

GET / HTTP/1.0
Host: cs.fyi
User-Agent: Mozilla/5.0 (Macintosh; Intel Mac OS X 10_10_5)
Accept: */*

正如您所看到的,客户端除了请求之外,还发送了自己的个人信息、所需的响应类型等信息。而在 HTTP/0.9 中,客户端永远无法发送此类信息,因为没有头部。

对于上述请求的示例响应可能如下所示:

HTTP/1.0 200 OK
Content-Type: text/plain
Content-Length: 137582
Expires: Thu, 05 Dec 1997 16:00:00 GMT
Last-Modified: Wed, 5 August 1996 15:55:28 GMT
Server: Apache 0.84

(response body)
(connection closed)

在响应的最开始,有 HTTP/1.0(HTTP 后跟版本号),然后是状态码 200,后跟原因短语(或状态码的描述,如果您愿意)。

在这个更新的版本中,请求和响应头仍然保持为 ASCII 编码,但响应正文可以是任何类型,例如图像、视频、HTML、纯文本或任何其他内容类型。因此,现在服务器可以向客户端发送任何内容类型;在介绍后不久,HTTP 中的“超文本”一词成为了误称。HMTP 或超媒体传输协议可能更有意义,但我想我们终身都会被这个名称困住。

HTTP/1.0 的主要缺点之一是无法在一个连接中处理多个请求。也就是说,每当客户端需要从服务器获取东西时,它都必须打开一个新的 TCP 连接,并且在单个请求被满足后,连接将被关闭。对于任何下一个需求,它都必须在新连接上进行。为什么这是不好的?好吧,假设您访问一个具有 10 个图像、5 个样式表和 5 个 JavaScript 文件的网页,总计有 20 个项目需要在请求该网页时获取。由于服务器在请求已被满足后立即关闭连接,因此将有一系列 20 个单独的连接,其中每个项目都将在其单独的连接上依次服务。这种大量的连接会导致严重的性能损失,因为需要新的 TCP 连接会因三次握手和慢启动而造成重大的性能损失。

三次握手​

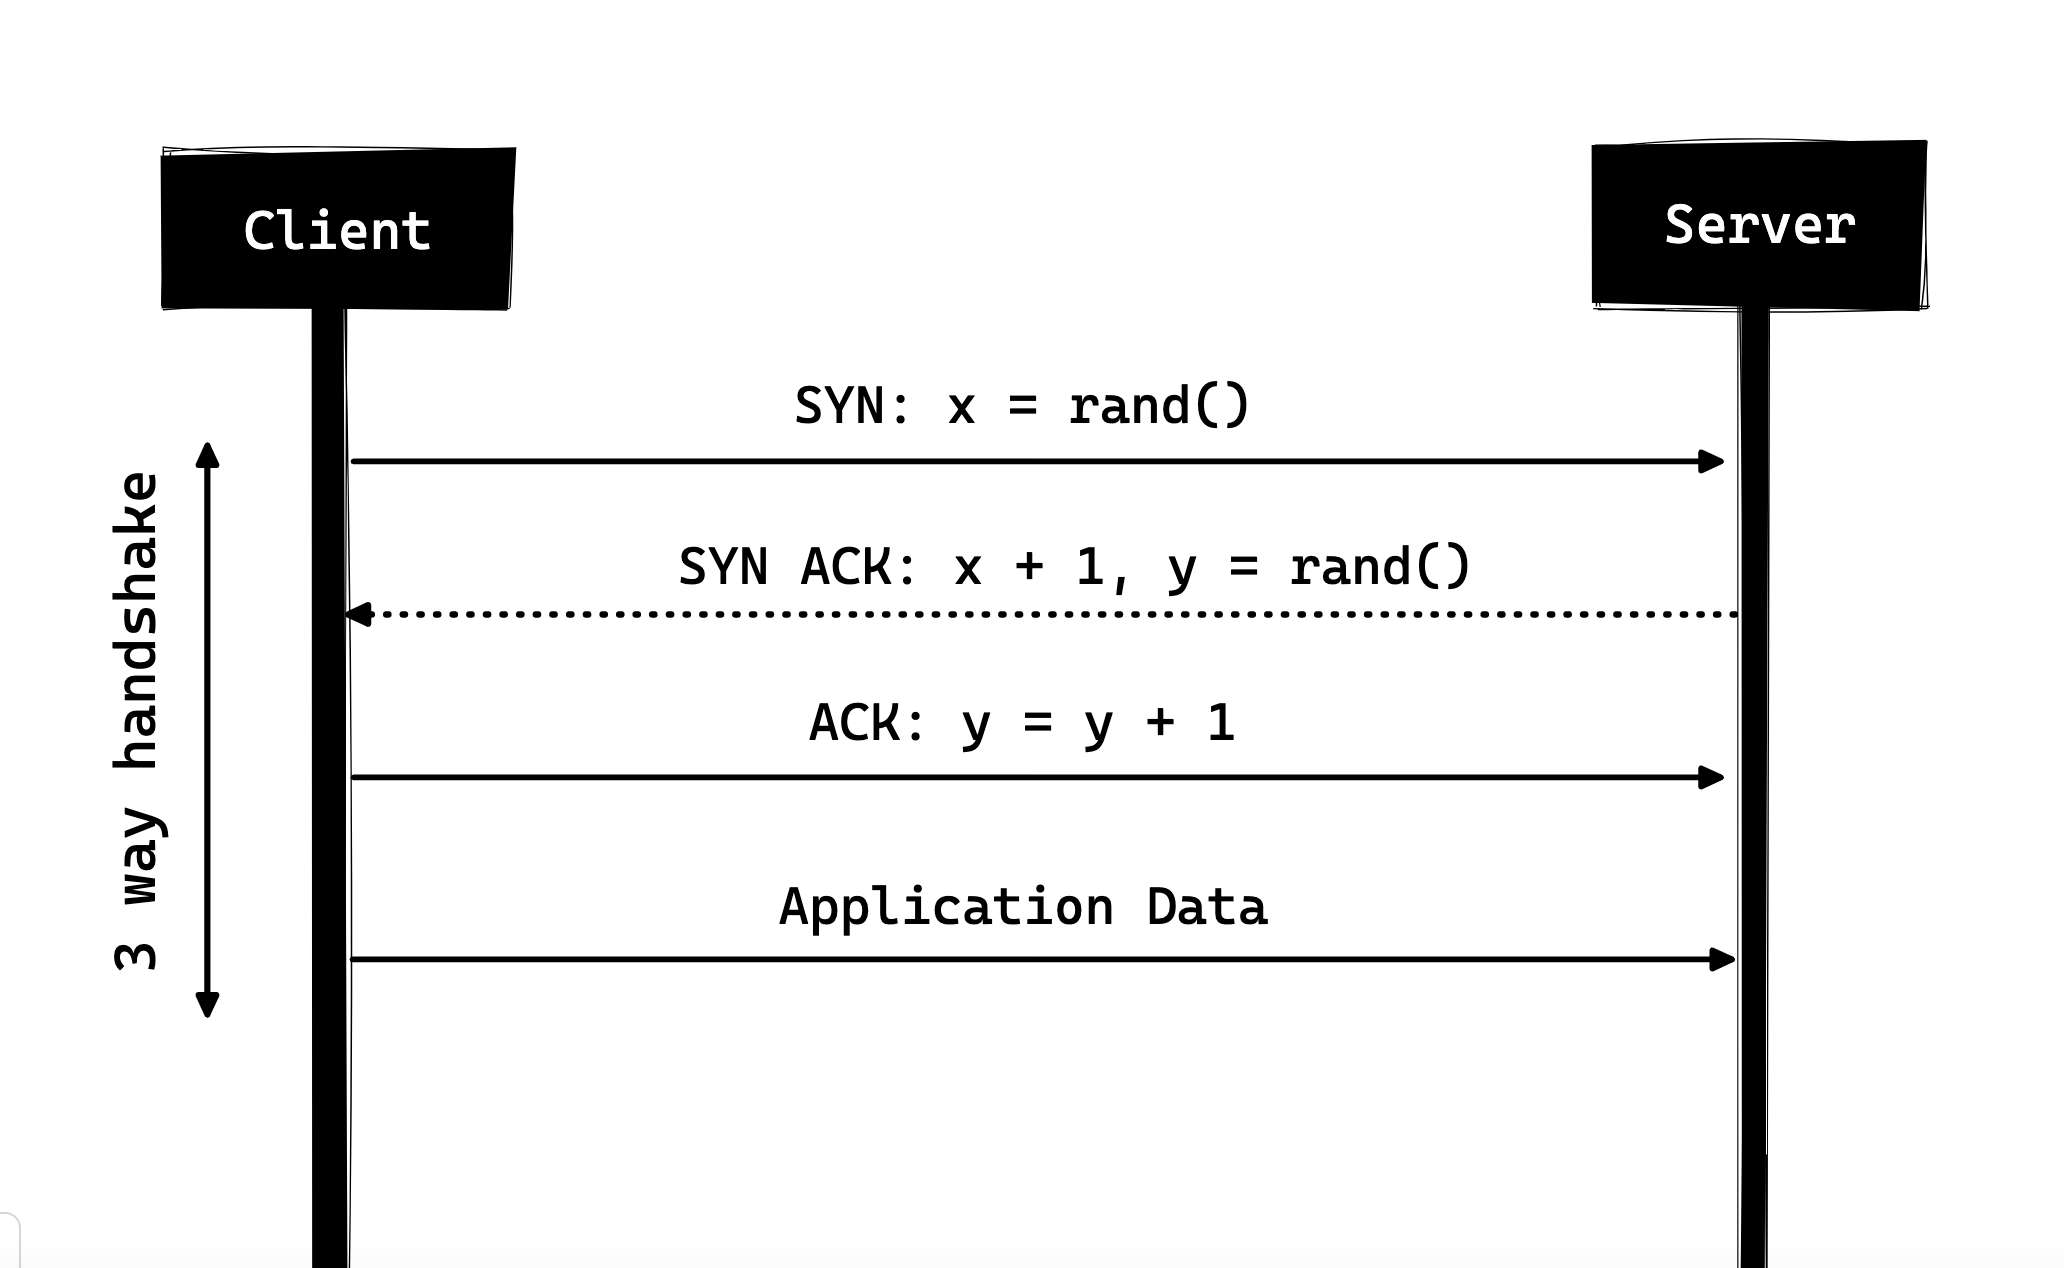
TCP 连接开始于三次握手,客户端和服务器在开始共享应用程序数据之前共享一系列数据包。

  • SYN - 客户端选择一个随机数,例如 x,并将其发送到服务器。
  • SYN ACK - 服务器通过向客户端发送一个由服务器选取的随机数(例如 y)和数字 x + 1 组成的 ACK 数据包来确认请求。
  • ACK - 客户端递增从服务器接收到的数字 y 并发送一个数字为 y + 1 的 ACK 数据包。

完成三次握手后,客户端和服务器之间的数据共享可以开始。需要注意的是,客户端可能会在发送最后一个 ACK 数据包后立即开始发送应用程序数据,但服务器仍然必须等待接收到 ACK 数据包才能满足请求。
然而,一些 HTTP/1.0 的实现尝试通过引入一个名为 Connection: keep-alive 的新头部来克服这个问题,该头部旨在告诉服务器“嘿服务器,不要关闭这个连接,我还需要它”。但它仍然没有得到广泛的支持,问题仍然存在。

除了是无连接的之外,HTTP 还是一种无状态协议,即服务器不维护有关客户端的信息,因此每个请求都必须具有服务器自行满足请求所需的信息,而不与任何旧请求相关联。因此,这加剧了问题,即除了客户端必须打开大量连接之外,它还必须在连接上发送一些冗余数据,导致带宽使用增加。

HTTP/1.1 - 1997​

HTTP/1.1 是 HTTP 的下一个版本,于 1999 年发布。相较于 HTTP/1.0,它有很多改进:

  • 新的 HTTP 方法被添加,包括 PUT、PATCH、OPTIONS、DELETE;
  • 在 HTTP/1.0 中,Host 头部不是必须的,但在 HTTP/1.1 中,它是必须的;
  • 持久连接:在 HTTP/1.0 中,每次连接只有一个请求,连接在请求被满足后立即关闭,这导致性能和延迟问题。HTTP/1.1 引入了持久连接,连接默认不关闭,允许多个连续请求。要关闭连接,请求中必须有头部 Connection: close。客户端通常在最后一个请求中发送此头部以安全地关闭连接;
  • 管道化:它还引入了管道化的支持,客户端可以在同一连接上向服务器发送多个请求,而无需等待服务器响应,服务器必须按照收到请求的相同顺序发送响应。但是,您可能会问客户端如何知道第一个响应下载完成并且下一个响应的内容开始。为了解决这个问题,必须存在 Content-Length 头部,客户端可以使用它来标识响应结束并且可以开始等待下一个响应。

持久连接或管道化请求需要在响应中有 Content-Length 头部,以便客户端知道何时传输完成,可以发送下一个请求(按照正常顺序发送请求)或开始等待下一个响应(启用管道化)。但是,这种方法仍然存在问题。如果数据是动态的,服务器无法提前找到内容长度怎么办?在这种情况下,持久连接无法发挥作用!为了解决这个问题,HTTP/1.1 引入了分块编码。在这种情况下,服务器可以省略 Content-Length,而采用分块编码(稍后详细介绍)。但是,如果两种方法都不可用,则必须在请求结束时关闭连接。

  • Chunked Transfers 是一种传输方式,通常用于传输动态内容。在传输开始时,由于服务器无法确定 Content-Length,因此它可能会分块(每个块为一小部分)发送内容,并在发送每个块时添加 Content-Length。当所有块都被发送完毕,即整个传输完成时,服务器会发送一个空块,即 Content-Length 设置为零,以便通知客户端传输已完成。为了通知客户端使用了 Chunked Transfers,服务器会包括头部 Transfer-Encoding: chunked。
  • HTTP/1.1 不同于仅有基本认证的 HTTP/1.0,它包括摘要认证和代理认证
  • 缓存
  • 字节范围
  • 字符集
  • 语言协商
  • 客户端cookies
  • 增强的压缩支持
  • 新的状态码
  • ...等等

HTTP/1.1 在 1999 年发布,成为标准多年。虽然它相对于前身做了很多改进,但随着 Web 技术的日新月异,HTTP/1.1 开始显得有些过时。如今,加载网页比以往任何时候都更加资源密集。一个简单的网页需要打开超过 30 个连接。虽然 HTTP/1.1 有持久连接,但为什么还需要这么多连接呢?原因是,在 HTTP/1.1 中,任何时刻只能有一个未完成的连接。HTTP/1.1 尝试通过引入管道化来解决这个问题,但它并没有完全解决,因为头部阻塞会阻止慢速或重量级请求,一旦请求被卡在管道中,它将不得不等待下一个请求的响应。为了克服 HTTP/1.1 的这些缺点,开发人员开始实现各种解决方法,例如使用 spritesheets、在 CSS 中编码图像、单个巨大的 CSS/JavaScript 文件、域分片等。

SPDY - 2009​

2009 年,Google 开始尝试使用替代协议来加速网络并改善 Web 安全性,同时减少 Web 页面的延迟。他们宣布了 SPDY 协议。

SPDY 是 Google 的商标,不是缩写。

人们发现,如果我们不断增加带宽,网络性能会在开始时增加,但在没有太多性能增益的时候会出现瓶颈。但是,如果您以同样的方式处理延迟,即如果我们不断降低延迟,就会有不断的性能增益。这是 SPDY 的性能提升的核心思想:降低延迟以提高网络性能。

对于那些不知道区别的人,延迟是延迟,即数据在源和目的地之间传输需要多长时间(以毫秒为单位),带宽是每秒传输的数据量(每秒比特数)。

SPDY 的功能包括复用、压缩、优先级、安全等。我不会详细介绍 SPDY,因为当我们进入下一节 HTTP/2 的细节时,您将会了解到它的主要灵感来源于 SPDY。

SPDY 实际上并没有试图替换 HTTP;它是 HTTP 上的翻译层,在应用程序层存在并在将请求发送到线上之前修改请求。它开始成为事实标准,并且大多数浏览器开始实现它。

2015 年,在 Google,他们不想有两个竞争标准,因此他们决定将其合并到 HTTP 中,同时推出 HTTP/2,废弃 SPDY。

HTTP/2 - 2015​

HTTP/2 的设计旨在进行内容的低延迟传输。从旧版本 HTTP/1.1 的关键特性或区别来看,HTTP/2 采用了以下特性:

  • 使用二进制代替文本
  • 多路复用 - 在单个连接上进行多个异步 HTTP 请求
  • 使用 HPACK 进行报头压缩
  • 服务器推送 - 为单个请求提供多个响应
  • 请求优先级
  • 安全性

二进制协议​

HTTP/2 试图通过将其变为二进制协议来解决 HTTP/1.x 中存在的延迟增加问题。作为二进制协议,它更易于解析,但与 HTTP/1.x 不同,它不再可读。HTTP/2 的主要构建块是帧和流

帧和流

HTTP 消息现在由一个或多个帧组成。有一个 HEADERS 帧用于元数据,一个 DATA 帧用于有效负载,还有几种其他类型的帧(HEADERS、DATA、RST_STREAM、SETTINGS、PRIORITY 等),你可以通过 HTTP/2 规范检查。

每个 HTTP/2 请求和响应都被赋予一个唯一的流 ID,并被划分为帧。帧只是二进制数据块。一组帧称为一个流。每个帧都有一个流 ID,用于标识它所属的流,每个帧都有一个公共头。另外,除了流 ID 是唯一的,值得一提的是,任何由客户端发起的请求都使用奇数,服务器的响应具有偶数流 ID。

除了 HEADERS 和 DATA 之外,我认为值得在此提到的另一种帧类型是 RST_STREAM,它是一种特殊的帧类型,用于中止某个流,即客户端可以发送此帧,让服务器知道我不再需要此流。在 HTTP/1.1 中,使服务器停止向客户端发送响应的唯一方法是关闭连接,这导致了延迟增加,因为必须为任何连续请求打开新连接。而在 HTTP/2 中,客户端可以使用 RST_STREAM 并停止接收特定流,而连接仍将保持打开状态,其他流仍将继续播放。

多路复用​

HTTP/2 现在是二进制协议,正如我上面所说,它使用帧和流来请求和响应,一旦打开 TCP 连接,所有流都通过同一连接异步发送,而不需要打开任何其他连接。反过来,服务器也以相同的异步方式响应,响应没有顺序,客户端使用分配的流 ID 来标识特定数据包属于哪个流。这也解决了 HTTP/1.x 中存在的阻塞问题,即客户端不必等待需要时间的请求,其他请求仍在处理中。

报头压缩​

HTTP/2 引入了报头压缩来优化发送的头部。该功能是在一个独立的 RFC 中实现的,旨在特别优化发送的头部。其要点在于,当我们始终从同一客户端访问服务器时,我们会反复发送许多冗余数据在头部中,有时可能会有增加头部大小的 cookie,导致带宽使用和延迟增加。为了克服这个问题,HTTP/2 引入了报头压缩。

与请求和响应不同,头部不是以 gzip 或 compress 等格式压缩的,而是采用了不同的头部压缩机制。该机制使用 Huffman 编码将文字值编码,并由客户端和服务器维护头部表。客户端和服务器都会在随后的请求中忽略所有重复的头部(例如用户代理等),并使用双方维护的头部表引用它们。

在谈论头部时,让我在这里添加一个信息,即头部仍然与 HTTP/1.1 中的头部相同,除了添加了一些伪头部,例如 :method、:scheme、:host 和 :path。

服务器推送​

HTTP/2 的另一个巨大的功能是服务器推送,在这种情况下,服务器知道客户端将要请求某个资源,因此可以将其推送到客户端,而无需客户端请求。例如,假设浏览器加载一个网页,它解析整个页面以找出必须从服务器加载的远程内容,然后发送相应的请求以获取该内容。

服务器推送允许服务器通过推送它知道客户端将要请求的数据来减少往返次数。它是通过发送称为PUSH_PROMISE 的特殊帧来完成的,该帧通知客户端:“嘿,我要将此资源发送给你!不要请求它。” PUSH_PROMISE 帧与引发推送的流关联,并包含承诺的流ID,即服务器将推送的资源所在的流。

请求优先级​

客户端可以在打开流的头部帧中包含优先级信息,以为流分配优先级。在任何其他时间,客户端都可以发送 PRIORITY 帧来更改流的优先级。

如果没有分配任何优先级信息,则服务器异步处理请求,即不按顺序处理请求。如果为流分配了优先级,则服务器根据此优先级信息决定需要分配多少资源来处理哪个请求。

安全性​

在 HTTP/2 的安全性问题上进行了广泛的讨论,是否应该强制要求使用 TLS。最终决定不强制要求,但大多数供应商表示,只有在使用 TLS 时才支持 HTTP/2。因此,尽管 HTTP/2 不需要加密,但从某种程度上来说,它已经默认成为强制要求。当使用 TLS 实现 HTTP/2 时,会有一些要求,例如必须使用 TLS 版本 1.2 或更高版本,必须具有一定水平的最小密钥大小,需要使用临时密钥等。

HTTP/3 - 2022​

HTTP/3 是 HTTP 的下一个版本。HTTP/3 是基于 QUIC 的协议。QUIC 是一个建立在 UDP 之上的传输层协议,旨在取代 TCP。它是一个多路复用、安全、基于流的协议,旨在降低延迟并提高性能。它是 TCP 和 HTTP/2 的继承者。

QUIC 是一个多路复用、安全、基于流的协议,旨在降低延迟并提高性能。它是 TCP 和 HTTP/2 的继承者。

多路复用​

QUIC 是一种多路复用协议,意味着可以在单个连接上发送多个流。这类似于 HTTP/2,其中可以在单个连接上发送多个流。然而,与 HTTP/2 不同,QUIC 不仅限于 HTTP。它可以用于任何需要可靠、有序和容错的流传输的应用程序。

基于流​

QUIC 是基于流的协议,这意味着数据以流的形式发送。每个流都由唯一的流 ID 标识。QUIC 使用单个流来双向发送数据。这类似于 HTTP/2,其中每个流由唯一的流 ID 标识,并且每个流是双向的。

不可靠数据报文​

QUIC 使用不可靠的数据报来发送数据。这意味着 QUIC 不能保证数据将被传送到接收者。不过,QUIC 保证数据将按照发送的顺序传送。这类似于使用 UDP,其中数据以数据报的形式发送,而数据报不能保证会传送到接收者。

连接迁移​

QUIC 支持连接迁移,这意味着 QUIC 连接可以从一个 IP 地址迁移到另一个 IP 地址。这类似于 TCP,其中 TCP 连接可以从一个 IP 地址迁移到另一个 IP 地址。

丢失恢复​

QUIC 使用丢失恢复来从数据包丢失中恢复。QUIC 使用拥塞控制和丢失恢复的组合来从数据包丢失中恢复。这类似于 TCP,TCP 使用拥塞控制和丢失恢复的组合来从数据包丢失中恢复。

拥塞控制​

QUIC 使用拥塞控制来控制网络上数据发送的速率。QUIC 使用拥塞控制和丢包恢复相结合来从数据包丢失中恢复。这类似于 TCP,其中 TCP 使用拥塞控制和丢失恢复相结合来从数据包丢失中恢复。

握手​

QUIC 使用握手来在客户端和服务器之间建立安全连接。QUIC 使用 TLS 1.3 在客户端和服务器之间建立安全连接。这类似于 HTTP/2,其中使用 TLS 1.2 在客户端和服务器之间建立安全连接。

报头压缩​

QUIC 使用头部压缩来减小头部的大小。QUIC 使用 HPACK 来压缩头部。这与 HTTP/2 类似,其中使用 HPACK 来压缩头部。

安全性​

QUIC 使用 TLS 1.3 在客户端和服务器之间建立安全连接。这类似于 HTTP/2,其中使用 TLS 1.2 在客户端和服务器之间建立安全连接。

总结​

在本文中,我们讨论了 HTTP/1.1,HTTP/2 和 HTTP/3。我们还讨论了 HTTP/1.1 和 HTTP/2 以及HTTP/2 和 HTTP/3 之间的区别。希望您会发现这篇文章有所帮助。

Backend Developer Roadmap 1

· 阅读需 11 分钟

Roadmap: https://roadmap.sh/backend

本文隶属于 Roadmap 中的 Internet --> How does the internet work?。

原文:https://cs.fyi/guide/how-does-internet-work

本文介绍了互联网的基础知识,包括互联网的定义、工作原理、基本概念、术语和常用协议。作为开发人员,了解互联网是如何工作的,以及如何利用其强大的互联性和连接性来构建高效、安全且可扩展的应用和服务是非常重要的。

Internet 介绍​

互联网是由许多网络组成的巨大网络,最初是为了应对核战争而建立的。如今,它已经成为现代生活的重要组成部分,被全球数十亿人用于访问信息、与亲友交流、开展业务等。作为开发人员,了解互联网如何工作,以及它的各种技术和协议是非常重要的。

Internet 工作原理概要​

互联网通过一系列标准化的协议连接设备和计算机系统。这些协议定义了设备之间如何交换信息,并确保数据可靠、安全地传输。

互联网的核心是由相互连接的路由器构成的全球网络,负责在不同设备和系统之间传输流量。当你发送数据时,它被分成小包并从你的设备发送到路由器。路由器检查数据包并将其转发到路径上的下一个路由器,重复此过程,直到数据包到达最终目的地。

为了确保数据包正确发送和接收,互联网使用了各种协议,包括网络协议(IP)和传输控制协议(TCP)。其中,IP 协议负责将数据包路由到正确的目的地,而 TCP 协议则确保数据包可靠地按正确顺序传输。

此外,还有许多其他技术和协议用于实现互联网上的通信和数据交换,包括域名系统(DNS)、超文本传输协议(HTTP)和安全套接字层/传输层安全协议(SSL/TLS)。作为开发人员,了解这些不同技术和协议如何协同工作,实现互联网上的通信和数据交换是非常重要的。

基本概念术语​

了解互联网的基本概念和术语是开发互联网应用和服务的关键,以下是一些需要了解的术语:

  • Packet:在互联网上传输的小数据单元。
  • Router:在不同网络之间传输数据包的设备。
  • IP Address:分配给网络上每个设备的唯一标识符,用于将数据路由到正确的目的地。
  • Domain Name:一个可读的人类可读的名称,用于标识网站,例如 google.com。
  • DNS:域名系统负责将域名转换为 IP 地址。
  • HTTP:超文本传输协议,用于在客户端(如 Web 浏览器)和服务器(如网站)之间传输数据。
  • HTTPS:HTTP 的加密版本,用于在客户端和服务器之间提供安全通信。
  • SSL/TLS:安全套接字层和传输层安全协议,用于在互联网上提供安全通信。

Internet 中协议的角色​

协议在启用互联网通信和数据交换方面扮演着至关重要的角色。协议是一组规则和标准,它们定义了设备和系统之间信息如何交换。

互联网通信中使用许多不同的协议,包括 Internet Protocol (IP),Transmission Control Protocol (TCP),User Datagram Protocol (UDP),Domain Name System (DNS) 等。

IP 负责将数据包路由到正确的目的地,而 TCP 和 UDP 确保数据包可靠和高效地传输。DNS 用于将域名转换为IP地址,而 HTTP 用于在客户端和服务器之间传输数据。

使用标准化协议的一个关键好处是它们允许来自不同制造商和供应商的设备和系统之间无缝通信。例如,一个由一家公司开发的 Web 浏览器可以与另一家公司开发的 Web 服务器通信,只要它们都遵守 HTTP 协议。

作为开发人员,了解互联网通信中使用的各种协议以及它们如何协同工作实现数据和信息在互联网上的传输是非常重要的。

使用 SSL/TLS 加密 Internet 连接​

SSL/TLS 是一种用于加密互联网传输数据的协议,通常用于为 Web 浏览器、电子邮件客户端和文件传输程序等应用程序提供安全连接。使用 SSL/TLS 时,需要理解以下几个关键概念:

  • Certificates: SSL/TLS 证书用于建立客户端和服务器之间的信任。它们包含有关服务器身份的信息,并由受信任的第三方(证书颁发机构)签名以验证其真实性。
  • Handshake: 在 SSL/TLS 握手过程中,客户端和服务器交换信息,以协商安全连接的加密算法和其他参数。
  • Encryption: 一旦建立安全连接,数据将使用约定的算法进行加密,并且可以在客户端和服务器之间安全传输。

构建基于互联网的应用程序和服务时,了解 SSL/TLS 的工作原理,并确保您的应用程序在传输敏感数据(例如登录凭据、付款信息和其他个人数据)时使用 SSL/TLS,以及确保您为服务器获取和维护有效的 SSL/TLS 证书,并按照配置和保护 SSL/TLS 连接的最佳实践进行操作,从而可以帮助保护用户数据,确保应用程序在互联网上的通信的完整性和保密性。

未来:新兴趋势和技术​

作为开发人员,了解互联网的最新发展趋势和技术非常重要,以下是一些正在塑造互联网未来的新兴技术和趋势:

  • 5G:是最新一代的移动网络技术,具有比以前更快的速度、更低的延迟和更大的容量。它预计将使新的用例和应用程序成为可能,例如自动驾驶汽车和远程手术。
  • 物联网:指连接到互联网并可以交换数据的物理设备、车辆、家用电器和其他物体的网络。随着物联网的不断增长,它预计将颠覆医疗保健、交通运输和制造等行业。
  • 人工智能:机器学习和自然语言处理等人工智能技术已经被用于推动广泛的应用和服务,从语音助手到欺诈检测。随着人工智能的不断进步,它预计将使新的用例成为可能,并改变医疗保健、金融和教育等行业。
  • 区块链:是一种分布式账本技术,可以实现安全的去中心化交易。它正在被用于支持从加密货币到供应链管理等广泛的应用程序。
  • 边缘计算:指在网络的边缘而不是在集中式数据中心中处理和存储数据。它预计将使新的用例和应用程序成为可能,如实时分析和低延迟应用程序。

通过了解这些和其他新兴趋势和技术,您可以确保您的应用程序和服务是基于最新功能构建的,并为您的用户提供最佳体验。

总结​

这篇文章介绍了互联网的基本概念,包括:

  • 互联网是由连接在一起的计算机组成的全球网络,使用标准化的通信协议交换数据。
  • 互联网通过将设备和计算机系统使用标准化协议(如 IP 和 TCP)连接在一起工作。
  • 互联网的核心是由相互连接的路由器构成的全球网络,负责在不同设备和系统之间传输流量。
  • 基本概念和术语包括分组、路由器、IP地址、域名、DNS、HTTP、HTTPS 和 SSL/TLS。

协议在启用互联网通信和数据交换方面扮演着至关重要的角色。协议是一组规则和标准,它们定义了设备和系统之间信息如何交换。使用标准化协议的一个关键好处是它们允许来自不同制造商和供应商的设备和系统之间无缝通信。希望这篇文章对您有帮助。

Nginx & Consul Usage

· 阅读需 8 分钟

介绍​

本文介绍了如何使用 Nginx & Consul,涉及到的方面不是很全面,只介绍了其中一部分使用方式。

Nginx​

Nginx 是一种 Web 服务器软件,它可以处理客户端请求并将其转发到后端服务。它还可以充当反向代理,将请求路由到不同的服务上。Nginx 通常用于构建高性能、高可扩展性的 Web 应用程序和 API。

Consul​

Consul 是一个服务发现和配置工具,用于管理分布式应用程序和服务。它提供了一个可靠的方式来发现和注册服务,并允许服务之间进行通信。Consul 还提供了一个 Web UI,用于查看当前注册的服务和健康状况。

Docker 镜像准备​

下载 Consul 的二进制文件:https://developer.hashicorp.com/consul/downloads,得到 consul 和 consul-template。

编写 entrypoint.sh:

#!/bin/sh

# 启动 Nginx 服务器
nginx

# 启动 Consul agent 服务器
# -server: 设置 Consul 服务器而不是客户端
# -bootstrap-expect: 开始启动集群之前期望的服务器数量
# -data-dir: 存储 Consul 数据的目录
# -bind: 绑定的 IP 地址
# -client: 绑定客户端接口的 IP 地址
# -ui: 启用 Web UI
consul agent -server -bootstrap-expect 1 -data-dir /consul -bind 0.0.0.0 -client 0.0.0.0 -ui &

# 启动 consul-template,当服务配置发生更改时重新加载 Nginx
# -consul-addr: 要使用的 Consul agent 的地址
# -template: 指定模板的源和目标文件
# : 指定模板更改时要运行的命令
consul-template -consul-addr 127.0.0.1:8500 -template /root/consul.template:/etc/nginx/conf.d/service.conf:"nginx -s reload"

编写 Dockerfile:

# 本 Dockerfile 设置 nginx-consul
# 它会复制必要的文件并运行入口脚本
# 入口脚本启动 nginx、Consul agent 和 consul-template
# 它还指定了 consul-template 命令,以便在服务配置更改时重新加载 nginx
# 请注意,此 Dockerfile 基于 nginx:stable-alpine

FROM nginx:stable-alpine

USER root

# 将 consul 和 consul-template 二进制文件复制到容器中
COPY consul /usr/bin
COPY consul-template /usr/bin

# 将 entrypoint.sh 复制到容器中
COPY entrypoint.sh /root/

# 为 Consul 数据创建目录
RUN mkdir /consul

# 将工作目录设置为 /templates
WORKDIR /templates

# 指定容器启动时要运行的入口脚本
ENTRYPOINT ["/root/entrypoint.sh"]

构建镜像:docker build -f Dockerfile . -t nginx-consul

Consul 模板​

Consul Template 是一个开源工具,用于在 Consul 中定义的键值对更改时自动更新应用程序配置文件。它允许您使用一组简单的模板语言来生成配置文件,并使用 Consul 的服务发现功能以及 Consul 配置更改通知机制来自动更新它们。这使得在使用 Consul 时更容易自动化应用程序配置管理。

下面是一个样例模板文件,名为consul.tmpl:

{{range services}} {{$name := .Name}} {{$service := service .Name}}
upstream {{$name}} {
zone upstream-{{$name}} 64k;
{{range $service}}server {{.Address}}:{{.Port}} max_fails=3 fail_timeout=60 weight=1;
{{else}}server 127.0.0.1:65535; # force a 502{{end}}
} {{end}}

server {
listen 80 default_server;

location / {
root /usr/share/nginx/html/;
index index.html;
}

location /stub_status {
stub_status;
}

{{range services}} {{$name := .Name}}
location /{{$name}} {
proxy_pass http://{{$name}};
}
{{end}}
}

上述模板文件用于生成 Nginx 的配置文件。在 upstream 部分,它定义了从 Consul 中发现的服务的列表,并将它们作为一组后端服务器添加到 Nginx 的 upstream 块中。每个服务都有一个唯一的名字,在模板中使用 {{$name := .Name}} 定义。然后,使用 service .Name 获取该服务的详细信息,例如地址和端口号。对于每个服务,都会创建一个 server 行,其中包括该服务的地址和端口号。如果 Consul 中没有找到该服务,则会添加一个带有 502 错误的服务器行,例如:server 127.0.0.1:65535; # force a 502。

运行 Consul​

在名为 consul-hostname 的机器上,运行如下指令:

docker run --rm --name consul \
-p 19000:80 \ # nginx
-p 19001:8500 \ # consul
--volume $PWD/consul.tmpl:/root/consul.template \
-v $PWD/data:/consul \
nginx-consul

在运行完上述指令后,能够在 http://localhost:19000 上访问 Nginx。还可以在 http://localhost:19001 上访问 Consul 的 Web UI,以查看当前注册的服务和健康状况。

注册服务​

假设我们使用 Python+FastAPI 实现了一个简单的 HTTP 服务,并在 server-hostname 的 7000 端口上运行。

from fastapi import FastAPI

app = FastAPI()

# 简单的 HTTP 服务
@app.get("/simple_http")
def simple_http():
return {"message": f"Hello from {app}"}

# 健康检查服务
@app.get("/health")
def health():
return {"status": "ok"}

运行如下指令可以将该服务注册到 Consul 上:

curl \
--request PUT \
--data @register.json \
http://<consul-hostname>:19001/v1/agent/service/register

其中register.json :

{
"Name": "simple_http",
"ID": "simple-1",
"Address": "<serve-hostname>",
"Port": 7000
}

运行如下指令可以将该服务的健康检查注册到 Consul 上:

curl \
--request PUT \
--data @health.json \
http://<consul>:19001/v1/agent/check/register

其中health.json :

{
"Name": "health check simple1",
"ID": "check:simple1",
"Interval": "5s",
"HTTP": "http://<serve-hostname>:7000/health",
"ServiceID": "simple-1",
"DeregisterCriticalServiceAfter": "1m"
}

health.json 文件中的设置表示健康检查的详细信息。以下是各个字段的含义:

  • Name: 健康检查的名称,用于标识检查的目的。
  • ID: 健康检查的 ID,必须是唯一的。
  • Interval: 指定 Consul 运行健康检查的时间间隔。在这个例子中,健康检查每 5 秒运行一次。
  • HTTP: 指定要进行健康检查的 HTTP 端点。在这个例子中,检查 /health 端点。
  • ServiceID: 指定要检查的服务的 ID。在这个例子中,它是 simple-1,与注册服务的 ID 相同。
  • DeregisterCriticalServiceAfter: 指定 Consul 在服务停止响应多少时间后将其从注册表中注销。在这个例子中,Consul 将在服务停止响应 1 分钟后注销。

总结​

本文介绍了如何使用 Nginx 和 Consul 管理分布式应用程序和服务。

使用 Nginx,我们可以处理客户端请求并将其转发到后端服务。Consul 则为我们提供了可靠的方式来发现和注册服务。

使用 Consul Template,我们可以自动更新应用程序配置文件,从而更好地管理整个系统。

通过本文介绍的实例,我们可以将一个简单的 HTTP 服务注册到 Consul 上,以实现更好的管理分布式应用程序和服务。

总的来说,使用 Nginx 和 Consul 可以提高分布式系统的可靠性和可维护性,使系统更加健壮和高效。

Rust Introduction

· 阅读需 12 分钟

官方教程​

https://doc.rust-lang.org/stable/book/

民间翻译版: https://kaisery.github.io/trpl-zh-cn/

Why Rust?​

from https://kaisery.github.io/trpl-zh-cn/ch00-00-introduction.html

Rust 程序设计语言能帮助你编写更快、更可靠的软件。在编程语言设计中,上层的编程效率和底层的细粒度控制往往不能兼得,而 Rust 则试图挑战这一矛盾。Rust 通过平衡技术能力和开发体验,允许你控制内存使用等底层细节,同时也不需要担心底层控制带来的各种麻烦。

from https://www.rust-lang.org/

Performance Rust is blazingly fast and memory-efficient: with no runtime or garbage collector, it can power performance-critical services, run on embedded devices, and easily integrate with other languages.

Reliability Rust’s rich type system and ownership model guarantee memory-safety and thread-safety — enabling you to eliminate many classes of bugs at compile-time.

Productivity Rust has great documentation, a friendly compiler with useful error messages, and top-notch tooling — an integrated package manager and build tool, smart multi-editor support with auto-completion and type inspections, an auto-formatter, and more.

安装​

https://kaisery.github.io/trpl-zh-cn/ch01-01-installation.html

rustup​

Rust 的版本管理命令行工具。

curl --proto '=https' --tlsv1.3 <https://sh.rustup.rs> -sSf | sh
rustc --version

更新

rustup update

快速上手​

Hello, World!​

// main.rs
fn main() {
println!("Hello, world!");
}

Then,

rustc main.rs
./main

Hello, Cargo!​

cargo new hello_cargo  // new project
cd hello_cargo
tree
.
├── Cargo.toml
└── src
└── main.rs
cargo build // debug build
cargo build --release // release build
cargo run // run program

Playground​

https://play.rust-lang.org/

基本语法​

变量与可变性​

变量分不可变与可变:

let x = 5; // immutable variable
x = 6; // error!
let mut y = 5; // mutable variable
y = 6; // ok!

常量:

const HALF: f32 = 0.5; // no `let`, must annotate its type!

数据类型​

标量

  • 整型
    • i8/u8, i16/u16, i32/u32, i64/u64, i128/u128, isize/usize
    • isize/usize 随计算机架构而变
  • 浮点型 f32/f64
  • 布尔型 bool
  • 字符类型 char

复合类型

  • 元组类型
    • (xx, xx, xx, ...), e.g. (i32, u8, f32)
  • 数组类型 -- 定长
    • [xx], e.g. [u8]
    • [xx; 长度] e.g. [u8; 5]

控制流​

if

fn main() {
let number = 6;

if number % 4 == 0 {
println!("number is divisible by 4");
} else if number % 3 == 0 {
println!("number is divisible by 3");
} else if number % 2 == 0 {
println!("number is divisible by 2");
} else {
println!("number is not divisible by 4, 3, or 2");
}
}

loop

实际上是 while True

fn main() {
let mut counter = 0;

loop {
counter += 1;

if counter < 5 {
continue;
} else if counter == 10 {
break;
} else {
println!("counter: {}", counter);
}
}
}

while

fn main() {
let a = [10, 20, 30, 40, 50];
let mut index = 0;

while index < 5 {
println!("the value is: {}", a[index]);

index += 1;
}
}

for

fn main() {
let a = [10, 20, 30, 40, 50];

for element in a {
println!("the value is: {element}");
}

for i in 0..a.len() {
println!("the value is: {}", a[i]);
}
}

函数​

函数

fn foo() -> () {
println!("hey!");
}

参数

必须声明参数类型。

fn foo(x: i32, y: i32) -> () {
println!("passing {} and {}", x, y);
}

返回值

一般返回无需 return 等关键词,直接写出要返回的值即可,也不用分号。

fn foo(x: i32, y: i32) -> i32 {
x + y
}

Option<T>: 可能是 空值 的返回类型

fn foo(x: i32, y: i32) -> Option<f64> {
if y == 0 {
None
} else {
Some(x as f64 / y as f64)
}
}

fn main () {
let ret = foo(2, 0);
if ret.is_none() { // check `ret` is none
println!("None occurs!")
} else {
println!("{}", ret.unwrap()); // `.unwrap()`: Option<T> -> T
}
}

Result<T, E>: 有潜在错误的返回类型

fn foo(x: i32, y: i32) -> Result<f64, &'static str> {
if y == 0 {
Err("divides zero!")
} else {
Ok(x as f64 / y as f64)
}
}

fn main () {
let ret = foo(2, 0).unwrap();
println!("{}", ret);
}

上述只用静态字符串来表达错误,这里还有使用真正的错误类型来表达错误的方式,以及许多错误传播的语法,本次不再细说。

结构体​

struct User {
active: bool,
username: String,
email: String,
sign_in_count: u64,
}

fn main() {
let user1 = User {
email: String::from("someone@example.com"),
username: String::from("someusername123"),
active: true,
sign_in_count: 1,
};
}

所有权 (ownership)​

from https://kaisery.github.io/trpl-zh-cn/ch04-01-what-is-ownership.html

所有程序都必须管理其运行时使用计算机内存的方式。一些语言中具有垃圾回收机制,在程序运行时有规律地寻找不再使用的内存;在另一些语言中,程序员必须亲自分配和释放内存。Rust 则选择了第三种方式:通过所有权系统管理内存,编译器在编译时会根据一系列的规则进行检查。如果违反了任何这些规则,程序都不能编译。在运行时,所有权系统的任何功能都不会减慢程序。

所有权规则:

  1. Rust 中的每一个值都有一个 所有者 ( owner )。
  2. 值在任一时刻有且只有一个所有者。
  3. 当所有者(变量)离开作用域,这个值将被丢弃。

变量作用域

    {                      // s 在这里无效, 它尚未声明
let s = "hello"; // 从此处起,s 是有效的

// 使用 s
} // 此作用域已结束,s 不再有效

移动

    let s1 = String::from("hello");
let s2 = s1; // "hello" has been moved to s2

println!("s1: {}, s2: {}", s1, s2); // compiler will complain!

因为整数是有已知固定大小的简单值,所以这两个 5 被放入了栈中。

但 String 由于有一个指向堆的指针(存储在栈上)

所以 let s2 = s1; 一句实际上做的是 move 操作(与 cpp 的 std::move 类似)

执行后 s1 变成了一个无效的变量,不能再被使用了。

克隆

连数据一起拷贝。未来提及 trait 时也有其他情况,这里不引入。

    let s1 = String::from("hello");
let s2 = s1.clone();

println!("s1 = {}, s2 = {}", s1, s2);

拷贝

栈上数据:基本类型。未来提及 trait 时也有其他情况,这里不引入。

    let x = 5;
let y = x;

println!("x = {}, y = {}", x, y);

所有权与函数

fn main() {
let s = String::from("hello"); // s 进入作用域

takes_ownership(s); // s 的值移动到函数里 ...
// ... 所以到这里不再有效

let x = 5; // x 进入作用域

makes_copy(x); // x 应该移动函数里,
// 但 i32 是 Copy 的,
// 所以在后面可继续使用 x

} // 这里, x 先移出了作用域,然后是 s。但因为 s 的值已被移走,
// 没有特殊之处

fn takes_ownership(some_string: String) { // some_string 进入作用域
println!("{}", some_string);
} // 这里,some_string 移出作用域并调用 `drop` 方法。
// 占用的内存被释放

fn makes_copy(some_integer: i32) { // some_integer 进入作用域
println!("{}", some_integer);
} // 这里,some_integer 移出作用域。没有特殊之处

返回值与作用域

fn main() {
let s1 = gives_ownership(); // gives_ownership 将返回值
// 转移给 s1

let s2 = String::from("hello"); // s2 进入作用域

let s3 = takes_and_gives_back(s2); // s2 被移动到
// takes_and_gives_back 中,
// 它也将返回值移给 s3
} // 这里, s3 移出作用域并被丢弃。s2 也移出作用域,但已被移走,
// 所以什么也不会发生。s1 离开作用域并被丢弃

fn gives_ownership() -> String { // gives_ownership 会将
// 返回值移动给
// 调用它的函数

let some_string = String::from("yours"); // some_string 进入作用域.

some_string // 返回 some_string
// 并移出给调用的函数
//
}

// takes_and_gives_back 将传入字符串并返回该值
fn takes_and_gives_back(a_string: String) -> String { // a_string 进入作用域
//

a_string // 返回 a_string 并移出给调用的函数
}

引用​

引用

引用 ( reference )像一个指针,因为它是一个地址,我们可以由此访问储存于该地址的属于其他变量的数据。 与指针不同,引用确保指向某个特定类型的有效值。

fn main() {
let s1 = String::from("hello");

let len = calculate_length(&s1);

println!("The length of '{}' is {}.", s1, len);
}

fn calculate_length(s: &String) -> usize {
s.len()
}

默认不允许修改引用的值。

可变引用

fn main() {
let mut s = String::from("hello");

change(&mut s);
}

fn change(some_string: &mut String) {
some_string.push_str(", world");
}

限制:如果你有一个对该变量的可变引用,你就不能再创建对该变量的引用。

    let mut s = String::from("hello");

let r1 = &mut s; // ok
let r2 = &mut s; // not ok!

println!("{}, {}", r1, r2);

理由是防止数据竞争,Rust 干脆在编译时期就不允许可能导致数据竞争的逻辑出现。

代码可以修改为:

    let mut s = String::from("hello");

{
let r1 = &mut s;
} // r1 在这里离开了作用域,所以我们完全可以创建一个新的引用

let r2 = &mut s;

另一种典型的错误:

    let mut s = String::from("hello");

let r1 = &s; // 没问题
let r2 = &s; // 没问题
let r3 = &mut s; // 大问题

println!("{}, {}, and {}", r1, r2, r3);

理由也是类似的:

不可变引用的用户可不希望在他们的眼皮底下值就被意外的改变了

代码可以修改为:

    let mut s = String::from("hello");

let r1 = &s; // 没问题
let r2 = &s; // 没问题
println!("{} and {}", r1, r2);
// 此位置之后 r1 和 r2 不再使用

let r3 = &mut s; // 没问题
println!("{}", r3);

悬垂引用(非法)

fn main() {
let reference_to_nothing = dangle();
}

fn dangle() -> &String { // dangle 返回一个字符串的引用

let s = String::from("hello"); // s 是一个新字符串

&s // 返回字符串 s 的引用
} // 这里 s 离开作用域并被丢弃。其内存被释放。
// 危险!

代码可以修改为:

fn no_dangle() -> String {
let s = String::from("hello");

s // 所有权被移动出去,所以没有值被释放
}

Site Reliability Engineering - Week 3 & 4

· 阅读需 2 分钟

https://www.coursera.org/learn/site-reliability-engineering-slos

References​

https://sre.google/

Developing SLI / SLO in 4 steps​

  1. Choose an SLI specification from the SLI menu
    • 确定 SLI 的大方向
  2. Refine the specification into a detailed SLI implementation
    • 确定 SLI 的实现细节
  3. Walk through the user journey and look for coverage gaps
    • 寻找 SLI 没有覆盖到的部分
  4. Set aspirational SLO targets based on business needs
    • 设置理想的 SLO 目标

分析系统中的风险​

围绕着一个 template excel 表格,来做各种分析。

https://goo.gl/bnsPj7

https://www.coursera.org/learn/site-reliability-engineering-slos/lecture/V8Edf/analyzing-risk 这里有使用方式。还没看得太透彻,之后如果有实战机会再补心得。

大致意思就是说,先列出系统中可能出问题的风险点,评估各种指标,并通过 SLO 来确定哪些风险是我们应该重点关注的。

为 SLO 写文档​

理由是您提供的服务无论用户还是开发者,以及上司,都需要知道服务的 SLO 是如何定义的,且如果 break 了,后果是什么。

建议包括以下三点:

  1. SLO 阈值如何设定?
  2. 为什么该 SLI 是可以合理度量 SLO 的?
  3. 指出哪些数据是不会被 SLI 统计的(非法请求)

SLO dashboard 例子:

Site Reliability Engineering - Week 2

· 阅读需 6 分钟

https://www.coursera.org/learn/site-reliability-engineering-slos

References​

https://sre.google/

SLI 指标设计​

不好的设计:直接使用系统监视图表(比如 CPU 使用率、内存使用率等),或者使用内部状态监视图表等。

理由是数据噪声大,而且通常和用户体验不呈直接影响的关系。

好的 SLI 指标应具有以下几个特点:

  1. Has predictable relationship with user happiness
    • 与用户幸福感具有可预测的关系
  2. Shows service is working as users expect it to
    • 能展现服务是按照用户期望的方式在运行
  3. Express as: good events / valid events
    • 可以表达为 良好请求 除以 合法请求
  4. Aggregated over a long time horizon
    • 在较长的时间窗口内聚合 SLI,以消除数据中的噪声

常用的 SLI​

两个常见场景如下:

Request / Response​

请求 & 反馈场景。比如 HTTP, RPC 等。

Availability

可用性。该 SLI 应设计为所有合法请求中成功的比例。

Latency

延迟。该 SLI 应设计为合法请求中响应速度快于阈值的比例。

Quality

服务质量。该 SLI 应设计为所有合法请求中保持服务质量的比例。

Data Processing​

数据批量处理场景。

Freshness

新鲜度。该 SLI 应设计为所有合法数据中生成时间快于阈值的比例。

通常需要时间戳来进行 SLI 指标计算。

Correctness

正确度。该 SLI 应设计为所有合法数据中正确的比例。

需要注意,不能用处理数据的逻辑来判断数据是否正确。

一种方法是可以使用 golden 输入输出对来对整体数据的正确程度进行估计。

Coverage

覆盖程度。该 SLI 应设计为所有合法数据中成功被处理的比例。

类似于上一节中的可用性 SLI。

Throughput

吞吐量。该 SLI 应设计为一段时间内处理速度快于阈值的时间占比。

复杂场景下的建议​

尽量减少 SLI 指标数,推荐 1~3 个。

太多 SLI 并不能使得每个指标都那么直观地表现系统的可靠程度。并且大量 SLI 会增加它们之间发生冲突的可能。

这并不意味着其他非 SLI 指标的监控图表也要同样被精简,它们可以帮助你来分析 SLI 低的原因。

同一种 SLI 在多种场景下的聚合​

直接将分子之和除以分母之和可能在大部分情况下适用,但也存在一些问题,比如当某一种场景流量较小时,该场景的 SLI 可能会被平滑掉。

可以使用更复杂一些的聚合策略,比如考虑流量相关的加权。

SLI 在多种场景下的阈值定义​

以请求的 latency 举例,典型的场景划分可以是:

  • 被第三方依赖的请求:因为不知道第三方的调用方式,所以我们不一定要为他们负责,所以只要确保能用即可,比如 10s
  • 后台请求:较松的时间阈值,比如 5s
    • 比如非人类用户(bot)等发出的请求
  • 写请求:较紧的时间阈值,比如 1.5s
    • 用户点提交按钮对反馈时间是比较宽容的
  • 交互请求:最紧,比如 400ms

设置合理的 SLO​

Achieveable SLOs​

用户期望与过去的表现密切相关。

如果你已有许多历史数据,则可以通过挖掘历史数据来设置 SLO。这种 SLO 被称之为可达到的 SLO。这种设置方式需要有一个假设,即假设用户对当前和过去的表现感到满意。

Aspirational SLOs​

没有历史数据怎么办?如果当前服务的表现并不好或者非常好,怎么设置 SLO?

根据业务需求指定的 SLO 被称之为理想 SLO。可以在服务上限之初,由产品团队来指定,之后可以动态调整。

持续优化​

首次设定 SLO 时,您需要观察、搜罗用户感受,并与您制定的 SLO 指标对比。

记得要定时查看 SLO 是否还合适,建议每年查看一次。

Site Reliability Engineering - Week 1

· 阅读需 6 分钟

https://www.coursera.org/learn/site-reliability-engineering-slos

References​

https://sre.google/

SLO: Service Level Objective​

服务水平目标。

虽然系统的可靠性非常重要,但也不能因为保证系统可靠而不开发新 feature。

所以需要平衡需求开发和保持系统可靠性是重要且具有挑战性的。

SLO 可以用来判定可靠性和其他新 feature 的优先级。

对于保持系统可靠运行的人来说,如果经常陷入救火->事件调查->重复性维护循环,就会被拖住。

此时,如果我们可以明确知道可靠性目标是什么,就不必陷入这种被动响应的循环。

这一点就需要 SLO 来介入,它可以回答系统的可靠性水平是多少这个问题。从而给决策人员通过数据来判定此时此刻是应该开发新 feature 或者提高系统可靠性。

SLO 三原则​

  1. Figuring out what you want to promise and to whom
    • 搞明白要承诺什么,向谁承诺
  2. Figuring out the metrics you care about that make your service for reliability good
    • 找出需要关心的指标,使得服务具有良好的可靠性
  3. Deciding how much reliability is good enough
    • 搞清楚上述指标达到多少就足够好了

SLA: Service Level Agreements​

服务水平协议,是提供服务者与用户之间达成的可靠性协议。如果违反了 SLA,则提供服务者应当承担后果。

一般来说,当提供服务者已经发现 SLA 被 break 时才收到警报,那么修复善后过程则非常贵。

所以需要将 SLO 作为阈值,来提前预警 SLA 被 break 的风险。

SLA vs SLO​

SLA 是存在后果的对外承诺;SLO 则是为了满足客户期望的内部承诺。

当系统的 SLO 被 break 时,就需要特别开始关注系统的可靠性与运行风险了。

Happiness Test: 幸福测试​

用来帮助设定 SLO 的值。当勉强满足 SLO 时,客户是开心的;反之,客户则是不满的。

挑战在于如何量化指标,如何衡量客户的幸福感。

比如客户可能由很多群体组成,每个群体的关注点不同。

SLI: Service Level Indicators​

服务水平指标,是对用户体验的测量指标。最好是表达所有有效时间中良好的比例,比如过去一段时间内成功请求所占所有合法请求的比例。

SLI = good events / valid events

Error Budgets: 错误预算​

用于平滑地表示 break SLO 的程度。当 error budget 达到 100% 时,意味着 SLO 已经被 break 了,需要把可靠性放在第一优先级来看。

当 error budget 还低时,就可以让新 feature 开发放在高优先的位置(可以采取更激进的发布),error budget 逐渐升高但还没超过 100% 时,就需要更保守的发布策略。

对于某种特定类型的故障来说,可以定义如下指标:

  • TTD: Time to detect
    • 从用户受到影响到 SRE on-call 来解决问题的时间
  • TTR: Time to repair & Time to resolution
    • 从发现问题到解决问题的时间
  • TTF: Time to failure
    • 故障发生的频率
  • 该故障对错误预算的预期影响 epsilon
epsilon = TTD * TTR * 故障影响因子% / TTF

减少故障对错误预算的影响,可以从以下几点出发:

  • 降低 TTD
    • 添加自动机制来捕获异常,比如自动警报、监视等
  • 降低 TTR
    • 通过写文档,打 log 来让错误更容易被定位与解决
    • 做一些简便的工具用来排查问题
  • 降低故障影响因子
    • 限制特定更改在一段时间内可能影响的用户数量
      • 基于百分比的更新,比如新功能仅推送给 0.1% 的用户,再一点点增加
    • 服务在故障期间以降级模式运行,比如只允许读但不允许写
  • 提高 TTF
    • 自动将流量引导至远离发生故障的区域

Summary​

  • 做好问题定义:SLOs & SLIs
  • 让系统恰好达到它应有的稳定程度,但不必做到 100% 的极致
  • 错误预算是沟通的基础
  • SLOs 不是永远不变的
  • 组织间需要较强的合作

pyenv instruction

· 阅读需 5 分钟

What is pyenv?​

pyenv is a Python version manager which is a tool to manage multiple Python versions.

pyenv-virtualenv is a tool to create isolated Python environments.

It allows pyenv and virtualenv to work together.

(pyenv-virtualenv 是一个可以将 pyenv 和 virtualenv 无缝连接起来的插件)[1]

Why use pyenv?​

When you develop multiple python projects, and these projects depends on different versions of Python or different Python libraries, you need this pyenv tool to manage Python versions or pyenv-virtualenv to manage different isolated environments with pyenv.

(当你在开发多个 Python 项目,且这些项目依赖了不同版本的 Python 或者不同库时,就会需要 pyenv 来管理 Python 版本或者使用 pyenv-virtualenv 来管理不同独立的 Python 环境)

How it works?​

Sample from https://github.com/pyenv/pyenv#how-it-works .

graph LR
cmd[Python-related command<br/>Like python, pip, ...] --> Shims
Shims --> pyenv

Simply to say, any Python-related command (like pip, python, pydoc...) will be executed by ~/.pyenv/shims/<command> first, then a proper Python version will be selected and the command will be executed

(简单来说,所有与 Python 相关的指令(比如 pip, python, pydoc...)都会被 ~/.pyenv/shims/<command> 执行,然后 pyenv 会选中一个合适的 Python 版本与环境来执行该指令).

Order of Python version selection​

  1. check PYENV_VERSION environment variable (could be set by pyenv shell). If it is set, use it. Otherwise, go to step 2.
  2. check .python-version file in the current directory (could be set by pyenv local). If it is set, use it. Otherwise, go to step 3.
  3. check .python-version file in all of the parent directories. If it is found, use it. Otherwise, go to step 4(找当前目录的所有父目录,看是否有 .python-version 文件。如果找到则使用,否则,转进到第 4 步).
  4. check $(pyenv root)/version file. If it is set, use it. Otherwise, use the default version defined by system.

Installation​

Sample from https://github.com/pyenv/pyenv#installation and https://github.com/pyenv/pyenv-virtualenv#installation .

For Linux/macOS​

End-to-end installation commands at my environments:

ENV-LAPTOP: Homebrew at macOS with zsh:

brew update
brew install pyenv
echo 'export PYENV_ROOT="$HOME/.pyenv"' >> ~/.zshrc
echo 'command -v pyenv >/dev/null || export PATH="$PYENV_ROOT/bin:$PATH"' >> ~/.zshrc
echo 'eval "$(pyenv init -)"' >> ~/.zshrc # install `pyenv` into your shell as a shell function, enable shims and autocompletion
brew install pyenv-virtualenv
echo 'eval "$(pyenv virtualenv-init -)"' >> ~/.zshrc

ENV-WORK: Ubuntu 20.04 with zsh:

git clone https://github.com/pyenv/pyenv.git ~/.pyenv
echo 'export PYENV_ROOT="$HOME/.pyenv"' >> ~/.zshrc
echo 'command -v pyenv >/dev/null || export PATH="$PYENV_ROOT/bin:$PATH"' >> ~/.zshrc
echo 'eval "$(pyenv init -)"' >> ~/.zshrc # install `pyenv` into your shell as a shell function, enable shims and autocompletion
git clone https://github.com/pyenv/pyenv-virtualenv.git .pyenv/plugins/pyenv-virtualenv
echo 'eval "$(pyenv virtualenv-init -)"' >> ~/.zshrc

For Windows​

pyenv does not support Windows yet. So I use pyenv-win instead.

Because pyenv is not supported at Windows, then pyenv-virtualenv is unavailable at Windows too. So I use virtualenv instead.

End-to-end installation commands at my environment:

ENV-PC: Windows 10 with PowerShell 7.2.1[4]:

git clone https://github.com/pyenv-win/pyenv-win.git "$HOME/.pyenv"
[System.Environment]::SetEnvironmentVariable('PYENV',$env:USERPROFILE + "\.pyenv\pyenv-win\","User")
[System.Environment]::SetEnvironmentVariable('PYENV_ROOT',$env:USERPROFILE + "\.pyenv\pyenv-win\","User")
[System.Environment]::SetEnvironmentVariable('PYENV_HOME',$env:USERPROFILE + "\.pyenv\pyenv-win\","User")
[System.Environment]::SetEnvironmentVariable('path', $env:USERPROFILE + "\.pyenv\pyenv-win\bin;" + $env:USERPROFILE + "\.pyenv\pyenv-win\shims;" + [System.Environment]::GetEnvironmentVariable('path', "User"),"User")

pyenv install <version>
pyenv global <version>
python -m pip install --user virtualenv

Usage​

pyenv/pyenv-win​

# check all installable Python versions
pyenv install --list
# install a specific Python version
pyenv install <version>
# use a specific Python version globally
pyenv global <version>
# use a specific Python version in current directory or in all of its subdirectories
pyenv local <version>
# use a specific Python version in the current shell
pyenv shell <version>

pyenv-virtualenv​

pyenv virtualenv <version> <env_name>
pyenv activate <env_name>
pyenv deactivate
# delete venv
pyenv virtualenv-delete <env_name>

virtualenv​

python -m venv <env_name>
source <env_name>/bin/activate # for unix-like systems
.\<env_name>\Scripts\activate # for Windows
deactivate
# delete venv
rm -rf <env_name>

Q & A​

Q: Error occurred: ERROR: The Python ssl extension was not compiled. Missing the OpenSSL lib?​

Run commands below[2]:

sudo apt-get update
sudo apt-get install make build-essential libssl-dev zlib1g-dev \
libbz2-dev libreadline-dev libsqlite3-dev wget curl llvm \
libncursesw5-dev xz-utils tk-dev libxml2-dev libxmlsec1-dev libffi-dev liblzma-dev

Q: Error occurred: ImportError: libpython3.8.so.1.0: cannot open shared object file: No such file or directory​

Run commands below[3]:

env PYTHON_CONFIGURE_OPTS="--enable-shared" pyenv install x.x.x
ls ~/.pyenv/version/x.x.x/lib

Q: Erorr occurred: ModuleNotFoundError: No module named '_lzma'​

Run commands below (MacOS):

brew install xz
pyenv uninstall <your_python_version>
pyenv install <your_python_version>

References​

Hugo with Docsy theme

· 阅读需 2 分钟

Install Hugo​

macOS​

brew install hugo   # install hugo-extended

Windows​

Download binary at release page of Hugo: https://github.com/gohugoio/hugo/releases .

For example, press Show all xx assets first, then download hugo_extended_x.xxx.x_windows-amd64.zip, then unzip it, and add the path of hugo.exe to PATH environment variable.

Install Docsy theme​

Preparation​

Install NodeJS first. Then install packages below:

  • autoprefixer
  • postcss-cli
  • postcss

For convenience, I construct a package.json at the root dir of my repo:

{
"devDependencies": {
"autoprefixer": "^10.4.7",
"postcss-cli": "^9.1.0",
"postcss": "^8.4.0"
}
}

For example, at MacOS:

brew install node   # install nodejs
npm install # install depdendencies

Clone Docsy theme​

Add Docsy as submodule to your repo:

git submodule add https://github.com/google/docsy.git themes/docsy
git submodule update --init --recursive # init submodules inside Docsy

Deploy using Github Action​

New a yaml file at .github/workflows/gh-pages.yml, contents as below:

name: GitHub Pages

on:
push:
branches:
- main

jobs:
deploy:
runs-on: ubuntu-latest
concurrency:
group: ${{ github.workflow }}-${{ github.ref }} # cancel same job if a newer commit's job is running
steps:
- uses: actions/checkout@v3
with:
submodules: recursive # recursively checkout submodules
fetch-depth: 0
- name: Setup Node
uses: actions/setup-node@v2
with:
node-version: 14.x
- name: Prepare for Docsy
run: npm install
- name: Setup Hugo
uses: peaceiris/actions-hugo@v2
with:
hugo-version: "latest"
extended: true # use hugo-extended
- name: Build
run: hugo --minify
- name: Deploy
uses: peaceiris/actions-gh-pages@v3
if: ${{ github.ref == 'refs/heads/main' }} # triggered only at main branch
with:
github_token: ${{ secrets.GH_TOKEN }} # needs to set actions secret variable first, https://docs.github.com/cn/actions/security-guides/automatic-token-authentication
publish_dir: ./public

Then you need to change your source branch to gh-pages at Settings > Code and automation > Pages > Source.

Example repo​

https://github.com/nero19960329/nero19960329.github.io

PEP 440 - Version Identification and Dependency Specification

· 阅读需 7 分钟

原文链接:https://peps.python.org/pep-0440/#version-specifiers

仅挑选部分说明,忽略了预发布、后发布与本地版本等内容。大部分机翻,少部分有语义调整。

摘要​

此 PEP 描述了一种用于识别 Python 软件发行版本并声明对特定版本的依赖关系的方案。

如 PEP 345 和 PEP 386 中所述,本文档解决了先前尝试标准化版本控制方法的几个限制。

版本格式​

公共版本标识符​

规范的公共版本标识符必须符合以下格式:

[N!]N(.N)*[{a|b|rc}N][.postN][.devN]

公共版本标识符不得包含前导或尾随空格。

公共版本标识符在给定的发行版中必须是唯一的。

公共版本标识符最多分为五个部分:

  • Epoch segment: N!
  • Release segment: N(.N)*
  • Pre-release segment: {a|b|rc}N
  • Post-release segment: .postN
  • Development release segment: .devN

任何给定的版本都将是以下部分中定义的 “final release”, “pre-release”, “post-release” 或者 “developmental release”。

所有数字组件必须是非负整数,表示为 ASCII 数字序列。

所有数字组件必须根据其数值进行解释和排序,而不是作为文本字符串。

所有数字分量可能为零。 除了下面对发布部分的描述之外,零的数字分量除了始终是版本排序中可能的最低值之外没有特殊意义。

最终发布​

仅由发布段和可选的时代标识符组成的版本标识符称为“最终版本”。

Release segment 由一个或多个非负整数值组成,以点分隔:

N(.N)*

项目中的最终版本必须以不断增加的方式编号,否则自动化工具将无法正确升级它们。

发布段的比较和排序依次考虑发布段的每个组成部分的数值。 当比较具有不同数量的组件的发布段时,较短的段会根据需要用额外的零填充。

虽然在此方案下允许在第一个组件之后添加任意数量的附加组件,但最常见的变体是使用两个组件(“major.minor”)或三个组件(“major.minor.micro”)。

版本说明符​

版本说明符由一系列以逗号分隔的版本条件组成。 例如:

~= 0.9, >= 1.0, != 1.3.4.*, < 2.0

比较运算符确定版本条件的类型:

  • ~=: 兼容发布条件
  • ==: 版本匹配条件
  • !=: 版本排除条件
  • <=, >=: 包含有序比较条件
  • <, >: 排除有序比较条件
  • ===: 任意相等条件

逗号 (“,”) 等效于逻辑与运算符:候选版本必须匹配所有给定的版本子句才能匹配整个说明符。

当多个候选版本与版本说明符匹配时,首选版本应该是由标准版本方案定义的一致排序确定的最新版本。

兼容发布​

匹配预期与指定版本兼容的任何候选版本。

指定的版本标识符必须采用版本格式中描述的标准格式。

对于给定的发布标识符 V.N,兼容的发布子句大致等价于如下两个比较子句:

>= V.N, == V.*

此运算符不得与单个段版本号(例如 ~=1)一起使用。

例如,以下几组版本条件是等价的:

~= 2.2
>= 2.2, == 2.*

~=1.4.5
>= 1.4.5, == 1.4.*

版本匹配​

指定的版本标识符必须采用版本格式中描述的标准格式,但在公共版本标识符上允许使用尾随 .*,如下所述。

通过在版本匹配条件中的版本标识符后面附加一个尾随 .* ,可以请求前缀匹配而不是严格比较。这意味着在确定版本标识符是否与子句匹配时,将忽略附加的尾随段。如果指定的版本仅包含发布段,则发布段中的尾随组件(或缺少的组件)也将被忽略。

版本排除​

与版本匹配正相反。

包含有序比较​

包含有序比较条件包括比较运算符和版本标识符,并且将根据标准版本方案定义的一致顺序,根据候选版本和指定版本的相对位置匹配比较正确的任何版本。

排除有序比较​

排除有序比较 > 和 < 类似于包含排序比较,因为它们依赖于候选版本和指定版本的相对位置,给定标准版本方案定义的一致排序。

例如,>1.7 将允许 1.7.1 但不允许 1.7.0。

任意相等​

任意相等比较是简单的字符串相等操作,它不考虑任何语义信息,例如零填充或本地版本。该运算符也不像 == 运算符那样支持前缀匹配。

任意相等的主要用例是允许指定一个不能由这个 PEP 表示的版本。 这个操作符是特殊的,它充当一个逃生舱口,允许使用实现此 PEP 的工具的人仍然安装与此 PEP 不兼容的旧版本。

一个例子是 ===foobar,它会匹配名为 foobar 的一个版本。

强烈建议不要使用此运算符,并且工具在使用时可能会显示警告。